Блог
Как проверить, видит ли Google тот же контент, что и ваши клиенты
Сравните исходный HTML, результат рендеринга и данные об индексировании, прежде чем из-за опасений по поводу JavaScript перестраивать сайт.
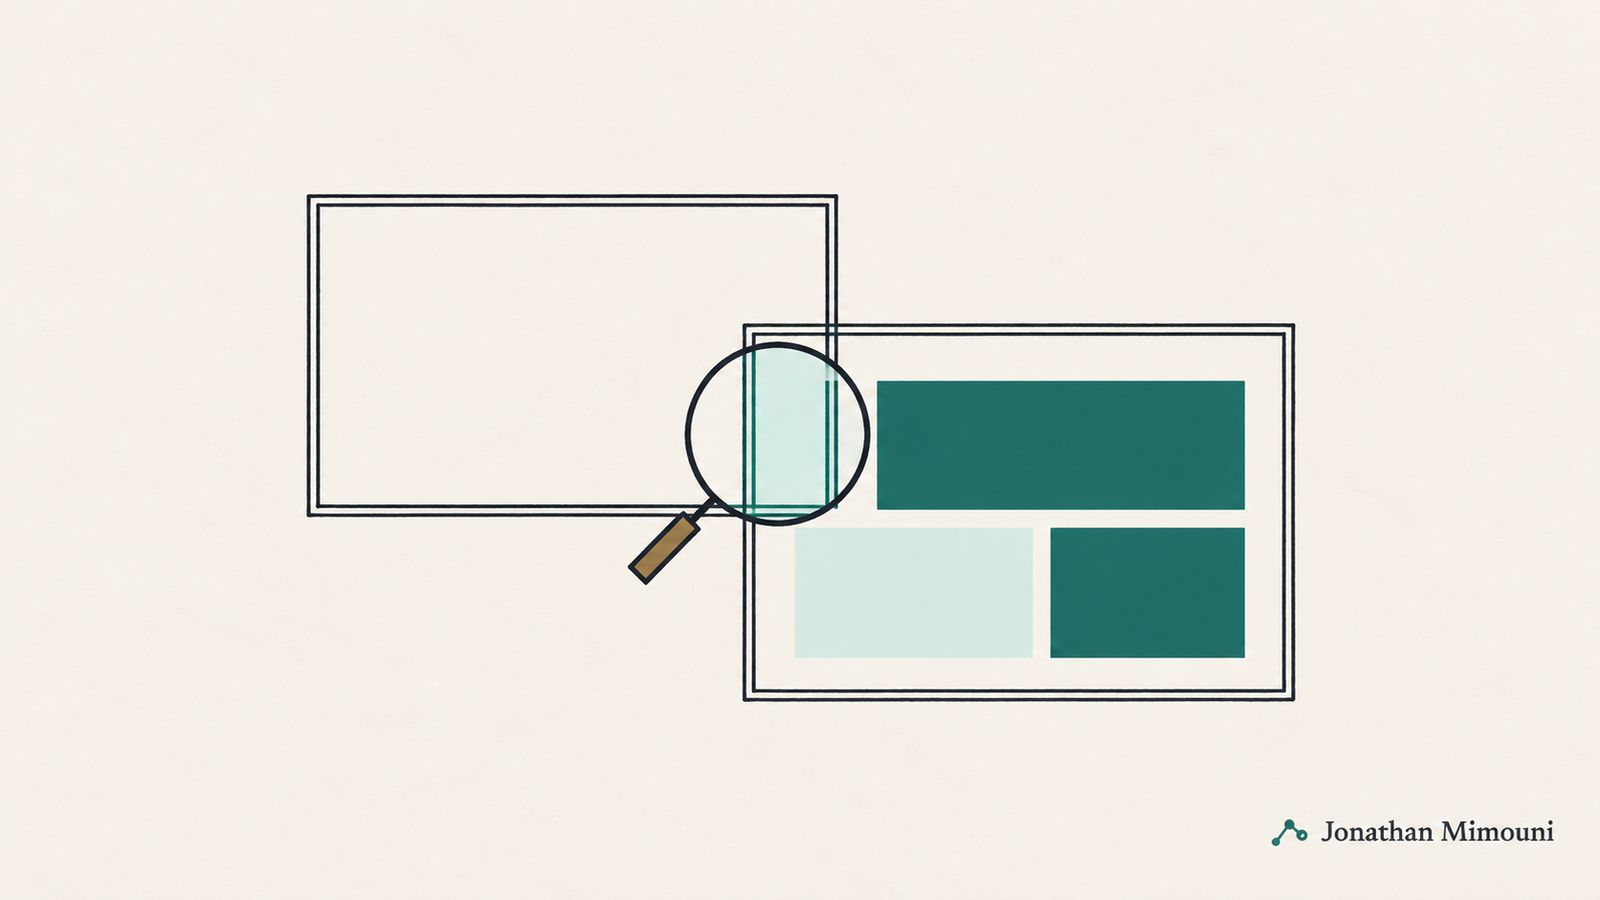
Страница может выглядеть полной в вашем браузере, хотя важная часть ее контента отсутствует в данных, доступных Google. Я бы исследовал это различие, прежде чем рекомендовать другой фреймворк, серверный рендеринг или перестройку сайта.
Первый полезный результат работы: точное описание того, что отсутствует, в какой версии страницы и почему это важно клиенту.
Выберите значимый контент
«Google не может прочитать наш сайт» является плохой постановкой задачи. Она объединяет предполагаемую причину с выводом обо всех страницах.
Я бы выбрал важный URL и определил его ключевой контент: например, описание услуги, характеристики продукта, сведения о местоположении или ссылки на связанные товары. Затем выбрал бы другой URL на том же шаблоне и еще один с иным поведением. Сравнение помогает отделить проблему отдельной записи от проблемы общего компонента.
Назначение для бизнеса нужно сформулировать прямо. Если название продукта есть, а информация о совместимости отсутствует, страница не пуста. Но она все равно может не отвечать на вопрос, ради которого нужна. И наоборот, отсутствие декоративной анимации вряд ли оправдывает такое же исследование, как отсутствие описания услуги.
Первичный выбор должен делать маркетинг вместе с ответственными за предложение. Разработчикам нужно согласованное описание ожидаемой страницы, а не необходимость угадывать коммерческие приоритеты по скриншоту.
Разберитесь в трех представлениях, которые сравниваете
Сервер отправляет исходный HTML-ответ. Затем JavaScript может добавлять или менять контент в браузере. Google также обрабатывает страницы через обход, рендеринг и индексирование, как объясняет его документация по JavaScript.
На этих этапах появляются разные объекты проверки. Просмотр исходного кода страницы помогает увидеть первоначальный HTML. Отрисованная страница в браузере показывает результат выполнения скриптов в этом браузере. Search Console предоставляет данные о записи Google в индексе и отдельную проверку в реальном времени.
Почти пустой исходный код не доказывает, что Google не может проиндексировать контент. Он может указывать на зависимость наполнения страницы от JavaScript. Так же и полная страница в браузере не доказывает, что робот получил те же ресурсы и успешно достиг того же результата.
Я бы подписывал каждое наблюдение. Скриншот клиентской сессии, исходный HTML и результат проверки дополняют друг друга. Если считать их взаимозаменяемыми, диагноз становится менее надежным.
Начните с данных индекса, затем проверьте текущую страницу
Для ресурса, к которому у команды есть доступ, проверьте точный URL в Search Console. Зафиксируйте указанный статус индексирования, сведения об обходе и выбранный canonical, если они доступны. Проверьте, не относится ли запись ко времени до значимого изменения сайта.
Затем запустите проверку в реальном времени, чтобы изучить текущую страницу. Google указывает, что такая проверка не предсказывает выбранный им canonical и не гарантирует индексирования. Успешный результат дает полезные сведения об этой проверке, но не доказывает, что исправление уже попало в индекс.
Где возможно, изучите полученный HTML и информацию о ресурсах. Найдите характерную фразу из важного контента, не полагаясь только на внешний вид. Используйте скриншот успешной проверки в реальном времени как еще одно представление результата.
Допустим, текущая проверка содержит полное объяснение услуги, а сохраненная запись отражает прежнюю версию. Следующее действие будет иным, чем если объяснения по-прежнему нет в текущей проверке. В одном случае речь об обработке обновленной страницы, в другом нужно исследовать страницу, которую сайт отдает сейчас.
Обычная проверка в браузере отвечает на более узкий вопрос
Посещение без входа в аккаунт может выявить зависимости, скрытые вашей обычной рабочей сессией. Страница может опираться на сохраненные настройки, предыдущий переход или запрос с авторизацией.
Откройте URL напрямую. Отметьте, появляется ли основной контент без выбора региона, нажатия кнопки или перехода с другой страницы. Если клиент сначала должен сделать выбор, зафиксируйте поведение, не предполагая, как с ним справляется каждый робот.
Отключение JavaScript показывает, что остается без выполнения скриптов. Я бы использовал это для понимания зависимости, а не для имитации Google. Google может выполнять JavaScript, и браузер с отключенными скриптами отвечает на другой вопрос.
Ошибка в консоли разработчика тоже является подсказкой, а не автоматическим доказательством проблемы индексирования. Свяжите ошибку с отсутствующим элементом. Сбой аналитического запроса и сбой запроса данных продукта могут одинаково тревожно выглядеть в списке, но иметь совершенно разные последствия для страницы.
Проверьте доступ и директивы до изменения архитектуры
Попросите техническую команду выяснить, доступны ли для загрузки ресурсы, необходимые отсутствующему контенту. Заблокированный скрипт, неудачный запрос данных или ограничение инфраструктуры могут объяснить расхождение без вывода о непригодности всего приложения.
HTTP-ответ страницы и инструкции индексирования тоже заслуживают внимания. Страница товара, которая показывает ошибку, но возвращает успешный код ответа, создает иную проблему, чем страница с правильным продуктом. Директива noindex на одном шаблоне может быть намеренной, а на другом случайной.
Google отдельно предупреждает: первоначальный noindex может привести к пропуску рендеринга, поэтому последующее удаление директивы через JavaScript ненадежно. Противоречащие друг другу объявления canonical также требуют проверки. Это конкретные особенности реализации, подтверждаемые данными, а не основание объявлять JavaScript непригодным для поиска.
Я бы ограничил техническую задачу: определить соответствующий ответ, ресурс или директиву, показать наблюдаемое несоответствие и попросить разработчика установить его причину и масштаб.
Составьте задачу, которую можно закрыть по доказательствам
Полезная передача задачи содержит небольшой набор проверяемых элементов:
- Затронутый URL и еще один пример на том же шаблоне.
- Точный контент или ссылка, которые должны появляться.
- Представление для клиента и результат проверки с четкими подписями.
- Условия проверки и значимые изменения при выпуске сайта.
- Наблюдаемый сбой отдельно от предположений.
- Условие, подтверждающее успешное исправление.
Для условного шаблона товара критерием приемки может быть наличие текста характеристик в текущем результате рендеринга при сохранении его видимости для клиентов. Последующие проверки индексирования являются отдельным этапом, завершение которого разработка не может обещать немедленно.
Такой формат также позволяет разработчику оспорить первоначальную гипотезу. Если данные указывают на ограничение доступа, а не на рендеринг, задача должна следовать за данными.
Увеличивайте масштаб решения только при достаточных основаниях
Формирование страницы на сервере может быть разумным архитектурным выбором, но связано с затратами и зависимостями. Я бы оценивал его с учетом реальной проблемы надежности, затронутых шаблонов, других роботов и общих требований сайта.
Иногда достаточно небольшого исправления. Иногда повторяющиеся сбои в ключевом контенте оправдывают более крупное изменение. Данные должны позволять различить эти случаи.
Чтобы хорошо организовать работу, маркетинговой команде не нужно предписывать архитектуру рендеринга. Нужно определить необходимый клиентам контент, показать, где он теряется, и добиваться исправления, которое можно продемонстрировать.
Напишите мне в WhatsApp, если нужна помощь в превращении опасений по поводу индексирования JavaScript в понятное техническое задание.
Связаться с JonathanСтатьи по теме
Какие решения я принимаю до согласования переноса сайта
Для переноса сайта нужны согласованные целевые страницы, критерии выпуска и ответственность за то, что произойдет после запуска.
Несколько страниц ранжируются по одному запросу: какие стоит менять
Общие запросы могут указывать на неясные роли страниц или на разные потребности. Разберитесь в причине, прежде чем удалять контент.