Blog
Comment vérifier si Google voit le contenu que voient vos clients
Comparez le HTML livré, le contenu rendu et les éléments d'indexation avant de transformer une inquiétude liée à JavaScript en refonte du site.
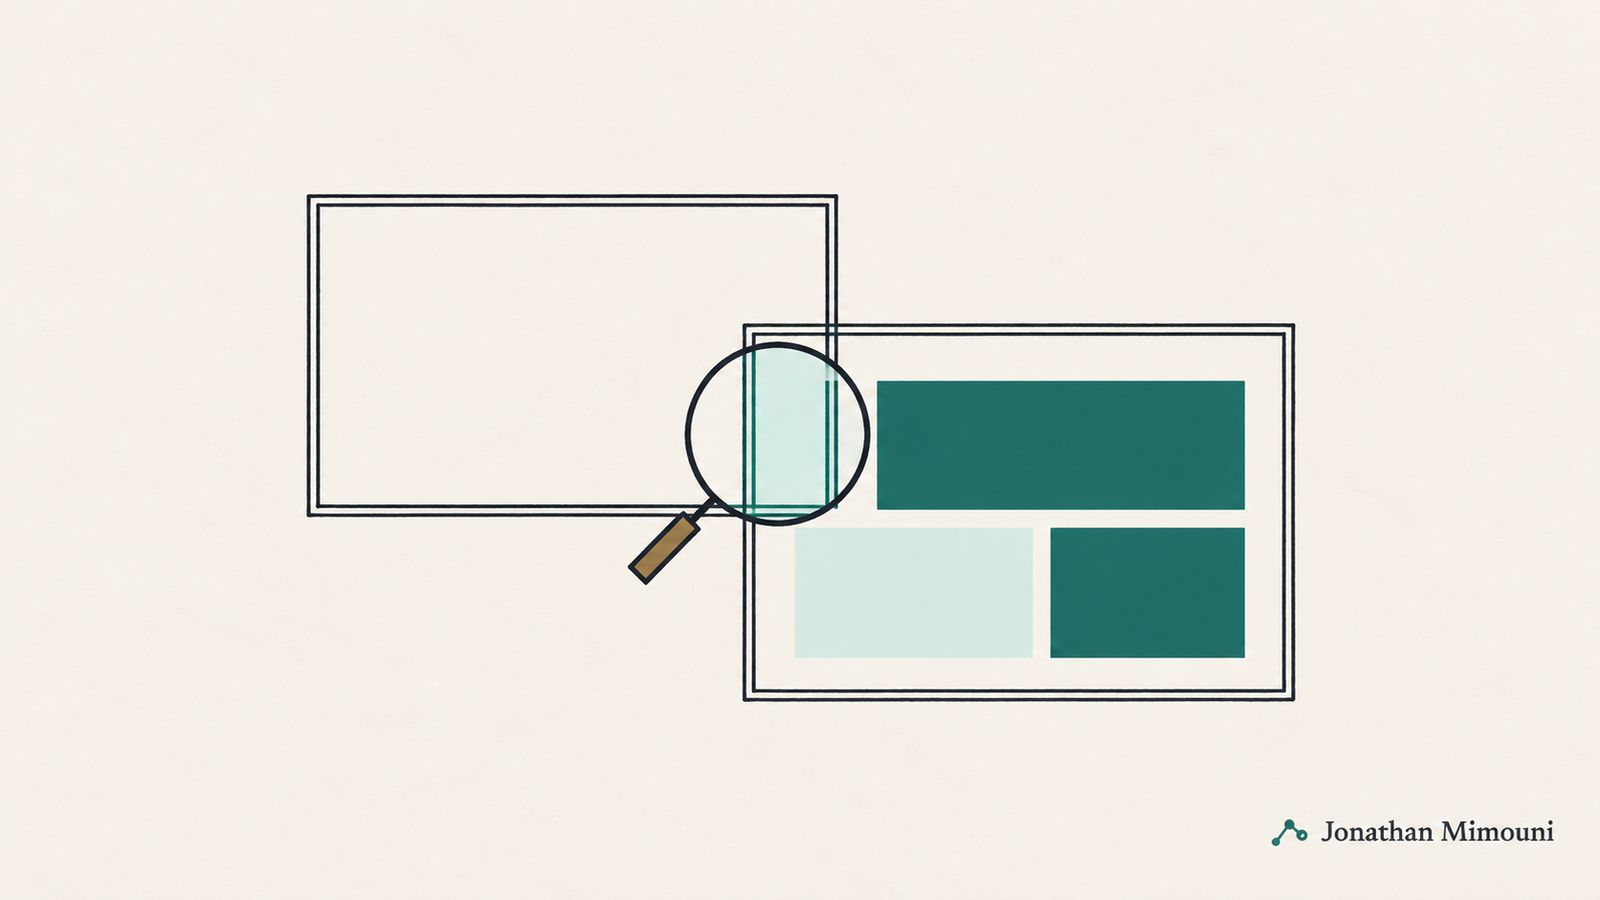
Une page peut sembler complète dans votre navigateur alors qu'une partie importante de son contenu manque dans les éléments accessibles à Google. J'examinerais cet écart avant de recommander un autre framework, un rendu côté serveur ou une refonte.
Le premier livrable utile est un énoncé précis de ce qui manque, de la version de la page concernée et de son importance pour le client.
Choisissez le contenu qui compte
« Google ne peut pas lire notre site » est un mauvais point de départ pour un ticket. Cette formulation combine une cause supposée et une conclusion sur l'ensemble des pages.
Je sélectionnerais une URL importante et identifierais son contenu essentiel : la description du service, les caractéristiques du produit, les informations de localisation ou les liens vers des produits associés, par exemple. Je choisirais ensuite une autre URL utilisant le même modèle et une troisième au comportement différent. Ces comparaisons aident à distinguer un problème propre à une fiche d'un problème de composant partagé.
L'objectif commercial doit être explicite. Si le nom d'un produit apparaît, mais que les informations de compatibilité manquent, la page n'est pas vide. Elle peut néanmoins ne plus répondre à la question qui fait son utilité. À l'inverse, l'absence d'une animation décorative justifie rarement la même investigation que celle d'une description de service.
Cette sélection initiale revient au marketing et aux responsables de l'offre. Les développeurs doivent recevoir une description validée de la page attendue, plutôt que devoir déduire ses priorités commerciales d'une capture d'écran.
Comprenez les trois vues que vous comparez
Le serveur envoie une réponse HTML initiale. JavaScript peut ensuite ajouter ou modifier du contenu dans le navigateur. Google traite aussi les pages par exploration, rendu et indexation, comme l'explique sa documentation sur JavaScript.
Ces étapes produisent des éléments différents à inspecter. L'affichage du code source aide à voir le HTML initial. La page rendue dans le navigateur montre le résultat après l'exécution des scripts dans ce navigateur. Search Console fournit des informations sur la version indexée par Google et un test en direct distinct.
Un fichier source qui paraît vide ne prouve pas que Google ne peut pas indexer le contenu. Il peut indiquer que le site dépend de JavaScript pour remplir la page. De même, une vue complète dans le navigateur ne prouve pas qu'un robot a reçu les mêmes ressources ni qu'il a obtenu le même résultat.
Je conserverais un libellé pour chaque observation. Une capture issue d'une session client, le HTML source et le résultat d'inspection sont des éléments complémentaires. Les traiter comme interchangeables rend le diagnostic moins fiable.
Commencez par la version indexée, puis testez la page actuelle
Pour une propriété à laquelle votre équipe a accès, inspectez l'URL exacte dans Search Console. Relevez l'état d'indexation indiqué, les informations d'exploration et l'URL canonical sélectionnée lorsqu'elle est disponible. Vérifiez si les données sont antérieures à une modification pertinente du site.
Lancez ensuite un test en direct pour examiner la page actuelle. Google précise que ce test ne peut pas prédire l'URL canonical qu'il sélectionnera et ne garantit pas l'indexation. Un résultat réussi apporte une information utile sur ce test, mais ne prouve pas que la version indexée intègre déjà la correction.
Lorsqu'ils sont disponibles, inspectez le HTML retourné et les informations sur les ressources. Recherchez une expression distinctive du contenu important, plutôt que de vous fier entièrement à l'apparence. Utilisez la capture du test en direct réussi comme une autre vue du résultat.
Supposons que le test actuel contienne l'explication complète du service tandis que les données enregistrées reflètent une version antérieure. Cela suggère une autre suite à donner qu'un test en direct où l'explication manque encore. Dans le premier cas, il s'agit du traitement d'une page mise à jour ; dans le second, il faut examiner la page actuellement livrée.
Utilisez un contrôle simple dans le navigateur pour une question plus ciblée
Consulter le site sans être connecté peut révéler des conditions cachées par votre session de travail habituelle. La page peut dépendre de préférences enregistrées, d'une étape de navigation préalable ou d'une requête authentifiée.
Ouvrez directement l'URL. Notez si le contenu principal apparaît sans sélectionner de région, cliquer sur un bouton ou passer par une autre page. Si le client doit d'abord faire un choix, consignez ce comportement sans présumer de la manière dont chaque robot le traite.
Désactiver JavaScript permet de voir ce qui reste sans exécution de scripts. Je m'en servirais pour comprendre cette dépendance, pas pour simuler Google. Google peut exécuter JavaScript, et un navigateur où les scripts sont désactivés répond à une autre question.
De même, une erreur dans la console de développement est un indice, pas la preuve automatique d'un problème d'indexation. Reliez l'erreur à l'élément manquant. Une requête de mesure d'audience échouée et une requête de données produit échouée peuvent sembler aussi inquiétantes dans une liste tout en ayant des conséquences très différentes sur la page.
Vérifiez les accès et les directives avant de changer l'architecture
Demandez à l'équipe technique d'examiner si les ressources nécessaires au contenu manquant peuvent être récupérées. Un script bloqué, une requête de données échouée ou une restriction d'infrastructure peuvent expliquer un écart sans remettre en cause toute l'application.
La réponse HTTP et les directives d'indexation de la page méritent aussi de l'attention. Une page produit qui affiche une erreur tout en renvoyant un code de succès pose un autre problème qu'une page qui livre le bon produit. Une directive noindex peut être intentionnelle sur un modèle et accidentelle sur un autre.
Google avertit explicitement qu'une directive noindex initiale peut l'amener à ne pas effectuer le rendu, ce qui rend peu fiable sa suppression ultérieure par JavaScript. Des déclarations canonical contradictoires nécessitent aussi une investigation. Ce sont des détails de mise en œuvre associés à des éléments concrets, pas des raisons de déclarer JavaScript incompatible avec le référencement.
Je délimiterais la demande technique : identifier la réponse, la ressource ou la directive concernée, montrer l'écart observé et demander au développeur d'en établir la cause et l'étendue.
Rédigez un ticket qui puisse être clôturé sur des preuves
Une transmission utile comprend un petit ensemble d'éléments vérifiables :
- L'URL concernée et un autre exemple utilisant le même modèle.
- Le contenu ou le lien exact qui doit apparaître.
- La vue du client et celle de l'inspection, clairement identifiées.
- Le contexte du test et tout changement de déploiement pertinent.
- La défaillance observée, en séparant les hypothèses.
- La condition qui démontrerait la réussite de la correction.
Pour un modèle de page produit fictif, le critère de validation pourrait être la présence du texte des caractéristiques dans le rendu du test en direct et son maintien à l'affichage pour les clients. Les contrôles d'indexation ultérieurs relèvent d'un suivi distinct, pas d'un résultat que le développement peut promettre immédiatement.
Cette structure permet aussi au développeur de remettre en question l'hypothèse initiale. Si les éléments indiquent une restriction d'accès plutôt qu'un problème de rendu, le ticket doit suivre ces éléments.
N'élargissez la solution que si le problème le justifie
Fournir le contenu côté serveur peut être un choix d'architecture pertinent, mais il implique des coûts et des dépendances. Je l'évaluerais au regard du problème réel de fiabilité, des modèles concernés, des autres robots et des besoins plus larges du site.
Parfois, la bonne réponse est une petite correction. Parfois, des défaillances répétées sur des contenus essentiels justifient un changement plus important. Les éléments recueillis doivent permettre de faire cette distinction.
Une équipe marketing n'a pas besoin de prescrire l'architecture de rendu pour bien piloter ce travail. Elle doit définir le contenu nécessaire aux clients, montrer où il disparaît et exiger une correction dont la réussite puisse être démontrée.
Écrivez-moi sur WhatsApp si vous avez besoin de transformer une inquiétude sur l'indexation JavaScript en brief technique clair.
Parler à JonathanArticles associés
Les décisions que je prendrais avant de valider une migration de site
Une migration exige des destinations validées, des critères de lancement et des responsabilités claires après la mise en ligne.
Plusieurs pages se positionnent sur la même requête : lesquelles modifier ?
Des requêtes communes peuvent révéler des rôles de page confus ou des besoins différents. Faites le diagnostic avant de supprimer du contenu.